La filosofía Unix: la idea que hace poderosa a la terminal
El problema: El mito de la herramienta perfecta
Hoy en día desarrolladores de software y administradores de sistemas de cómputo nos enfrentamos con el uso de herramientas de software voluminosas que requieren de espacios importantes de almacenamiento en disco y consumen importantes cantidades de recursos de hardware para resolver tareas que no se compadecen con el volumen y esfuerzo de estas grandes herramientas. Ejemplo de ello lo podemos encontrar con frameworks como Django, un framework batteries-included de desarrollo ampliamente usado en la comunidad de desarrolladores de Python y que te ofrece un ORM, un panel de administración y un sistema de autenticación cuando muchas veces solo se quiere un API de tres líneas de código. El navegador Chrome, conocido por su estabilidad, también se apoya en una arquitectura multiproceso que lo puede llevar a consumir importantes cantidades de memoria RAM y ciclos de CPU. Estas son herramientas tipo todo en uno que ofrecen muchas capacidades y funcionalidades, pero que en algunos casos pueden ser más de lo que necesitamos para resolver una tarea concreta.
Estas herramientas voluminosas y complejas de mantener nos han alejado de herramientas de software más sencillas, más livianas, más eficientes y menos voraces en el consumo de hardware; que igualmente nos permiten alcanzar soluciones a nuestros problemas informáticos.
Idea central: los pilares de diseño del sistema operativo Unix
Unix es un sistema operativo con más de 50 años de edad. Este sistema operativo fue ideado por Ken Thompson y Dennis Ritchie en Bell Labs en 1969 y se forja en un contexto donde los computadores eran extremadamente costosos y escasos. Por esos tiempos, se transicionaba de los grandes computadores conocidos como mainframes a las minicomputadoras dentro de las que se destacan la PDP-7 y PDP-11. Estas computadoras seguían teniendo restricciones en cuanto a los recursos de hardware que proporcionaban. Es en este contexto de escasez de recursos de hardware donde la necesidad de programas que gestionen de forma eficiente se hace palpable. Son los sistemas operativos los encargados de llevar a cabo esta tarea de gestión y uno de ellos y el más prominente fue el sistema operativo Unix.
El diseño y posterior desarrollo de Unix se basó en premisas revolucionarias que ya se conocen como la Filosofía Unix:
Mantenlo pequeño y simple (KISS - Keep It Simple, Stupid). El desarrollo del código y las aplicaciones alrededor del sistema Unix deben priorizar la simplicidad sobre la complejidad. La sencillez era un objetivo de diseño del sistema operativo.
Haz una cosa y hazla bien (DOTADIW - Do One Thing And Do It Well) esta frase acuñada por Doug McIlroy es una directriz que señala que cada componente y aplicación del sistema operativo debe hacer una sola tarea y esa tarea debe quedar bien hecha. Esto contrasta con la idea de software moderno “todo en uno” que busca integrar muchas funcionalidades dentro de una misma herramienta.
Componibilidad La idea de tener piezas de software sencillas, que hacen bien su tarea nos plantea un desafío respecto de cómo con estas piezas de software se pueden crear soluciones de software a la medida de las necesidades de los usuarios. Es así como nace la idea de componibilidad y que hace referencia a la capacidad de poder conectar estas piezas de software como si fueran piezas de LEGO usando tuberías (pipes). La idea del pipe es propuesta por McIlroy (
|) y permite usar la salida de un programa como entrada de otro programa.El texto plano como interfaz de comunicación Con el mecanismo de composición de aplicaciones sobre la mesa se establece que la forma como se intercambia información entre aplicaciones será el texto plano. Es así como los comandos en Unix presentan la información de forma legible para el ser humano e interpretable por otro comando.
Muchos recursos se tratan como archivos o flujos En Unix y en los sistemas tipo Unix, muchos recursos del sistema se exponen mediante una interfaz común que permite leer, escribir o conectar información. No significa que todo sea literalmente un archivo regular, sino que la abstracción de archivo y de flujo facilita que programas distintos puedan comunicarse usando mecanismos comunes.
Ejemplo mínimo: calculando el consumo de espacio en disco
Uno de los problemas más recurrentes que tenemos los profesionales técnicos y usuarios de sistemas de cómputo es el espacio en disco. Es muy frecuente que nos preguntemos ¿Por qué el sistema me alerta de que mi disco se está quedando sin espacio? ¿A dónde se nos están yendo los gigabytes de mi disco duro?
En sistemas de entorno gráfico la opción es abrir un analizador visual de consumo de espacio en disco. Sin embargo, si ya tu sistema está teniendo problemas con la gestión de espacio de almacenamiento, abrir otra aplicación gráfica puede ser contraproducente y propiciar un entorno aún más restrictivo para que el sistema operativo siga llevando a cabo su tarea de gestión de recursos.
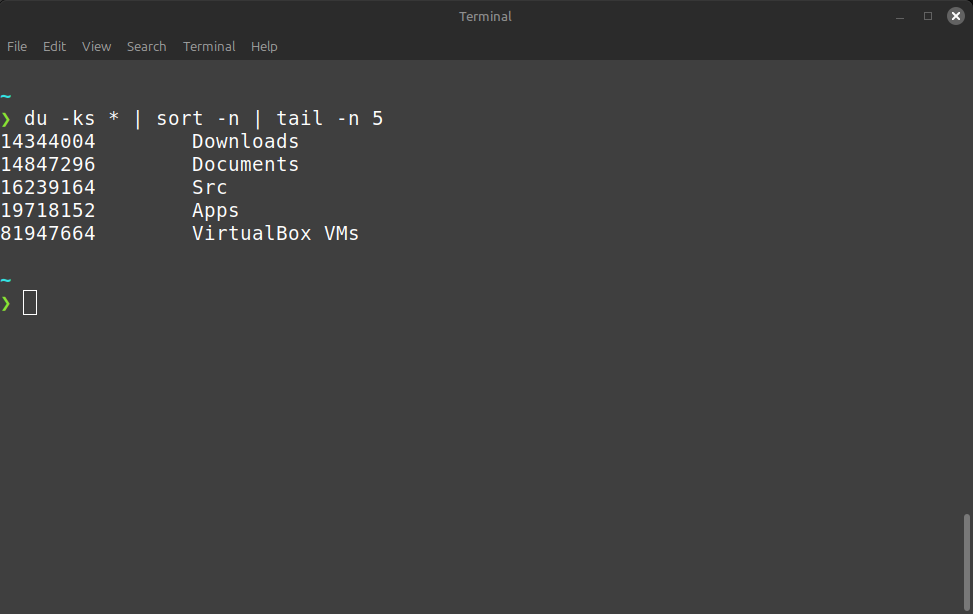
La Filosofía Unix nos ofrece una alternativa liviana, rápida y eficiente combinando tres herramientas sencillas a través de la línea de comandos. Si ejecutas el siguiente comando, este te devolverá las 5 entradas, archivos o directorios, que más espacio ocupan en tu directorio actual de trabajo:
du -ks * | sort -n | tail -n 5
Es importante notar que el patrón * toma las entradas visibles del directorio actual. No incluye archivos o directorios ocultos que comienzan por punto, como .cache o .config. Más adelante podremos revisar cómo incluir ese tipo de rutas cuando sea necesario.
Explicación paso a paso
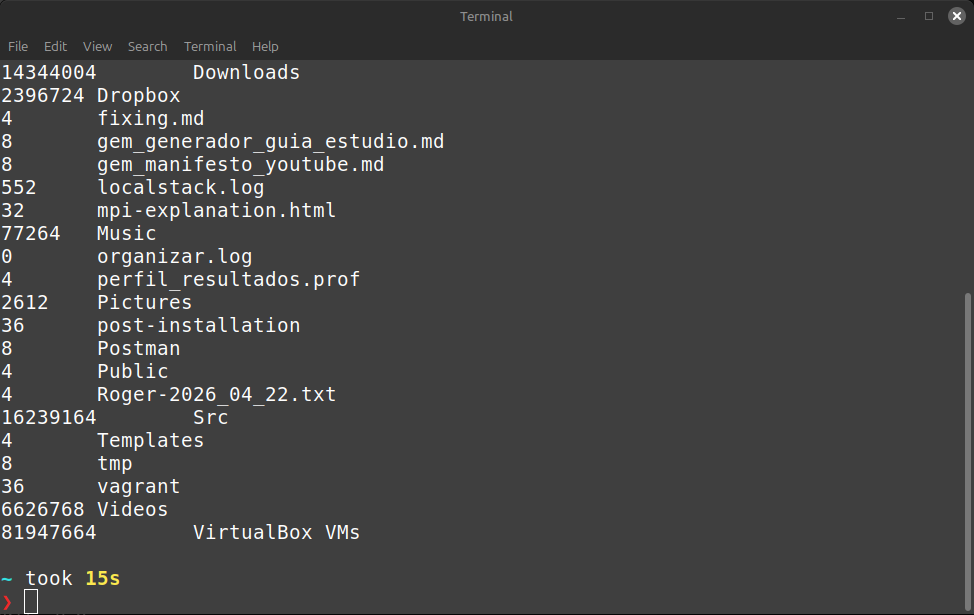
du(Disk Usage): En los sistemas tipo Unix, este comando calcula el consumo de espacio de tus archivos. Si lo ejecutas solo, notarás una lista interminable de nombres de archivos y directorios (en mi caso, ¡más de 110,000 líneas por pantalla!). Para modificar su comportamiento, añadimos las opciones-k(medir en bloques de 1 kilobyte) y-s(mostrar un resumen por carpeta). El asterisco*no es parte dedu; es una instrucción para que el shell considere o expanda el comando a todos los archivos y carpetas visibles del directorio actual. La salida del comando no está ordenada. Ver la siguiente figura:
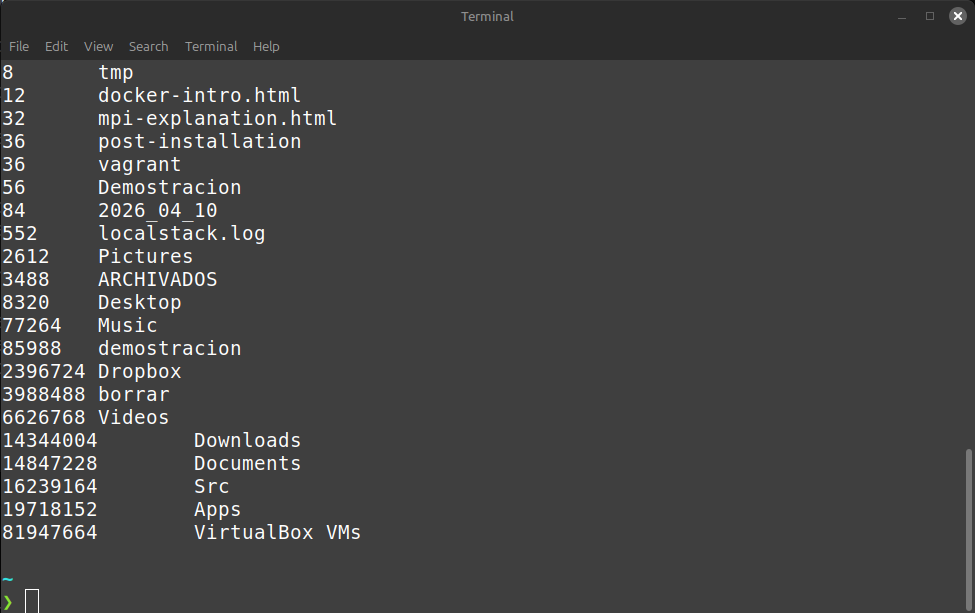
sort -n(Ordenar numéricamente): Para resolver el ordenamiento, acudimos a otra herramienta especializada. El comandosortordena líneas de texto, habitualmente de forma alfabética. Al pasarle la opción-n, le indicamos que ordene por valor numérico. Para inyectarle los datos que arroja la ejecución del comandodu, usamos la tubería o pipe (|), conectándolos así:du -ks * | sort -n.
tail -n 5(El filtro final): Tras el ordenamiento, las entradas más pesadas quedan al final de una larga lista. Como solo nos interesan los archivos y/o directorios más voluminosos en tamaño en disco, conectamos un tercer comando:tail.tailes un comando diseñado exclusivamente para mostrar el final de un flujo de texto. Con la opción-n 5, le pedimos que conserve únicamente las últimas 5 líneas.
Versión práctica
Hemos visto cómo tres comandos ejecutados desde la versátil línea de comandos nos permiten obtener rápidamente la información que requerimos.
Sin embargo, la información de consumo de espacio en disco se muestra en unidades de kilobytes y con los nuevos tamaños de los archivos (en gigabytes o terabytes) comprender o interiorizar el tamaño consumido por un archivo o directorio se hace un poco difícil.
El comando du tiene el modificador -h que permite tener información legible para el ser humano (-h viene de human readable).
Sin embargo, este modificador puede arrojar por pantalla valores como 1G y 2K y el comando sort entendería (por el 1) que 1G es más pequeño que 2K (2 va después del 1).
El comando sort tiene también el modificador -h que permite tener en cuenta ese sufijo (K o M o G o T). Dicho esto, para el sort con este modificador -h efectivamente 2K iría primero que 1G ya que son unidades diferentes y no compararía únicamente por el valor numérico.
Nuestro comando quedaría entonces como:
du -hs * | sort -h | tail -n 5
Al ejecutar esta línea en tu terminal, puedes ver cómo la componibilidad de Unix se adapta perfectamente a las particularidades del almacenamiento moderno.
Riesgos y precauciones
El comando propuesto en esta entrada es completamente seguro y no alterará ni borrará tus datos, sin embargo, debes tener en cuenta ciertos supuestos antes de ejecutarlo en cualquier entorno de producción:
- Errores de permisos: El comando
duexamina recursivamente cada directorio desde el lugar donde es invocado. Por ejemplo, si lo ejecutas en la raíz de tu sistema (/) o en carpetas de configuración del sistema (como/varo/etc) sin privilegios de superusuario (sudo), tu pantalla empezará a mostrar muchos mensajes del tipoPermission denied(Permiso denegado). El comando seguirá funcionando para los archivos que sí puede leer, pero la salida visual se llenará de información que te puede distraer. - Sistemas de archivos en red (NFS): Si ejecutas este pipeline dentro de una carpeta accesible a través de la red con protocolos como el de NFS,
dutendrá que calcular el tamaño viajando por la infraestructura de red, lo que podría congelar temporalmente tu terminal o degradar el rendimiento del servidor remoto si las carpetas contienen millones de archivos pequeños.
Cómo puede ayudar la IA
La Inteligencia Artificial es una excelente aliada para ayudarnos a descifrar “tuberías” o pipelines complejos antes de ejecutarlos. El pipeline que vimos hoy es relativamente sencillo, pero se le pueden agregar otros programas que pueden llegar a ser muy complejos y allí la IA puede ser un gran tutor para aprender y comprender más sobre aplicaciones de la línea de comandos.
Ahora, no dejes que la IA escriba los comandos por ti sin comprenderlos; utilízala como un asistente pero pídele que te explique lo que está haciendo.
Intenta el siguiente prompt en tu modelo de lenguaje preferido para analizar variaciones del comando de hoy:
“Actúa como un intérprete conceptual de la terminal Unix. Te proporcionaré un pipeline de comandos enlazados por pipes (
|) y tu tarea es descomponerlo paso a paso. Explícame qué hace cada comando de forma aislada bajo el principio de ‘hacer una sola cosa bien’ (DOTADIW) y cómo fluye el texto plano de un eslabón al siguiente. El primer comando que quiero que analices es:du -hs * | sort -h | tail -n 5”
Reto para el lector
Otra forma de aprender es intentar nuevas formas de hacer las cosas. En particular con los comandos de la terminal, es muy importante intentar formas diferentes de llevar a cabo las tareas.
Imagina que no queremos la salida del pipeline que estudiamos el día de hoy por pantalla sino en un archivo. Entonces, modifica el pipeline que aprendimos hoy para que la terminal no te muestre el resultado en la pantalla, sino que lo escriba de forma automática en un archivo de texto llamado reporte_espacio.txt dentro de tu directorio actual.
- Pista: Investiga cómo utilizar el operador de redirección mayor que (
>) al final de la secuencia para enviar el flujo de texto plano hacia un archivo físico. Tener la información en archivos permite que esta información sea accesible a futuro por otros seres humanos o por otros programas que quieran auditar la salud de tu sistema.
Qué aprendiste
En esta primera entrada, hemos sentado las bases de un cambio de mentalidad:
- El software grande no siempre es obligatorio: Frente a las herramientas monolíticas “todo en uno” que pueden consumir muchos recursos de hardware, la terminal demuestra que la simplicidad arquitectónica sigue siendo eficiente.
- Los legos de la terminal: Aprendiste que comandos pequeños y ciegos entre sí (como
du,sortytail) pueden unirse dinámicamente mediante tuberías (|) para resolver un problema de diagnóstico de forma eficiente. - El texto como lenguaje universal: Comprendiste que el flujo de caracteres legibles por humanos es la interfaz perfecta para que máquinas y personas colaboren de manera fluida y modular.
En la próxima entrada seguiremos con una idea fundamental: cómo Linux organiza archivos, directorios y rutas. Esa será la base para movernos con seguridad por la terminal y empezar a resolver problemas reales desde el sistema de archivos.